社内のシステムが突然止まり、各部署から問い合わせが一斉に届く。
情シス担当者にとって、緊張が走る場面です。
障害対応の成否を分けるのは、発生後の技術力だけではありません。
連絡先や判断の基準を平時に決めてあれば、原因がわからない段階でも迷わず動けるからです。
本記事では、情報システムの障害が起きる原因と発生時の対応手順、再発を防ぐ備えを順に解説します。
障害への備えを見直す際の手引きとしてお役立てください。
情報システムの障害対応でお悩みなら「情シス君」
一次対応から予防策の整備までご支援します
「障害が起きても、社内に切り分けられる担当者がいない」
「手順や連絡体制を整えたいが、日々の業務で手が回らない」
障害への備えは、役割と手順を決めた時点から機能し始めるものです。
「IT顧問 情シス君」は、ネットワークやサーバー、セキュリティまで幅広い領域をご支援します。
サービス資料では、障害時の一次対応から予防策の整備まで、支援の範囲と進め方を紹介しています。
社内で担う範囲と外部に任せる範囲を切り分ける材料としてご活用ください。
目次
情報システム障害の基本
障害への対応を考える前に、言葉の意味と種類を整理しておきましょう。
社内で使う用語がそろうと、障害時の報告や判断が速くなります。
障害の定義
情報システムの障害とは、システムが本来の機能を提供できなくなった状態のことです。
完全な停止だけでなく、処理の遅延や一部機能の不全、データの不整合も含まれます。
利用者から見れば、画面が開かない状態も極端に遅い状態も「使えない」点は同じでしょう。
停止していなくても業務に支障が出ていれば障害として扱うと、対応の遅れを防げます。
エラーやインシデントとの違い
障害と混同されやすい言葉に、エラーとインシデントがあります。
区別の軸は、事象を捉える範囲と視点です。
| 用語 | 意味 | 例 |
|---|---|---|
| エラー | プログラムや機器が想定外の結果を返した状態 | 入力画面で処理が失敗し、エラーメッセージが表示される |
| 障害 | システムが本来の機能を提供できない状態 | 基幹システムにログインできず、受注の入力が止まる |
| インシデント | 利用者が通常どおりサービスを使えない事象の全般 | 障害に加え、操作方法がわからず業務が止まった場合も含む |
| セキュリティインシデント | 情報の安全性を脅かす事象 | 不正アクセス、マルウェアへの感染、情報漏えい |
エラーが積み重なった結果として、障害に至る場合もあります。
障害は、インシデントのうちシステム側に原因がある事象と整理すると区別しやすいでしょう。
サイバー攻撃が原因の障害では、復旧の作業とセキュリティ上の対応を並行して進めます。
関連記事:インシデントとは?情報セキュリティにおける影響と防止策、対処方法を詳しく解説
障害の種類
障害は、発生する箇所によって5つに分類できます。
分類を決めておくと、原因の切り分けや記録の集計がしやすくなるはずです。
| 種類 | 主な例 |
|---|---|
| ハードウェアの障害 | サーバーのディスクの故障、電源装置の故障、端末の故障 |
| ソフトウェアの障害 | プログラムの不具合、更新プログラムの適用による不具合 |
| ネットワークの障害 | 回線の断絶、ルーターやスイッチの故障、DNS(ドメイン名とIPアドレスを対応づける仕組み)の設定不備 |
| クラウド・外部サービスの障害 | SaaS(インターネット経由で利用する業務ソフト)の停止、クラウド基盤の停止 |
| データ・設定の障害 | 設定値の誤り、証明書やライセンスの期限切れ、データの破損 |
1件の障害に、複数の分類がまたがる場合もあります。
記録の際は、最初に異常が起きた箇所を主な分類として選びましょう。
社内で起きやすい障害
情シスに届く障害の申告は、利用者の困りごととして寄せられます。
申告の内容から疑う箇所の見当をつけられると、切り分けの時間は短くなるでしょう。
| 利用者からの申告 | まず疑う箇所 |
|---|---|
| インターネットにつながらない | 回線、ルーター、無線LANのアクセスポイント |
| 共有フォルダが開けない | ファイルサーバーやNAS(ネットワークに接続する記憶装置)、アクセス権限 |
| メールを送受信できない | メールサービスの稼働状況、DNSの設定、容量の上限 |
| 業務システムが遅い | サーバーの負荷、ディスクの空き容量、同時に接続している人数 |
| クラウドサービスにログインできない | サービス側の障害、認証の設定、アカウントのロック |
| 社外から社内に接続できない | VPN(社外から社内ネットワークに安全に接続する仕組み)の機器、証明書の期限 |
| 複数の部署で同時に使えない | ネットワークや認証サーバーなど共通の基盤 |
申告が1人からか複数の部署からかは、影響範囲を見積もるうえで重要な手がかりです。
同じ時間帯に似た申告が重なった場合は、個別の不具合ではなく障害として扱いましょう。
障害の主な原因
障害の原因は、社内に起因するものと社外に起因するものに分かれます。
原因ごとの特徴を知っておくと、予防策の優先順位を決めやすくなるでしょう。
内部要因と外部要因
障害の原因は、内部要因と外部要因の2層で捉えると整理しやすいでしょう。
内部要因は、社内の設定や機器、運用に起因する原因です。
外部要因は、サイバー攻撃や災害、委託先のサービスなど社外に起因する原因を指します。
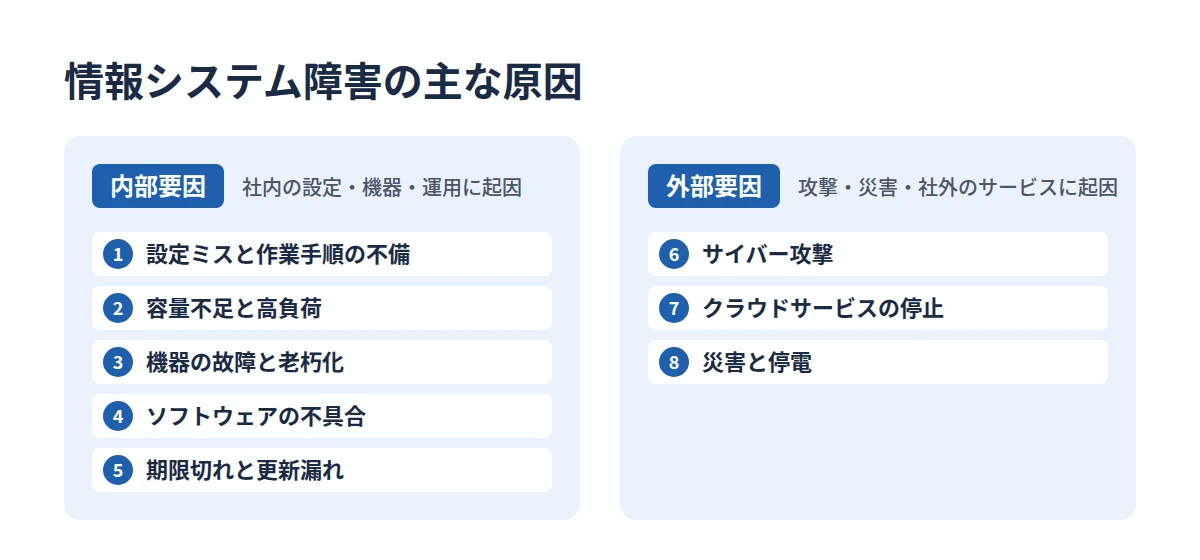
内部要因は、社内のルールや設備への投資で発生の確率を下げられます。
外部要因は発生を防ぎきれない場合が多いため、起きた後の影響を小さくする備えが中心になるでしょう。
1. 設定ミスと作業手順の不備
1つ目は、設定の誤りや作業手順の不備によって起きる障害になります。
人が手を動かす作業には、確認の漏れや思い込みが入り込む余地があるためです。
特に、手順書がない作業や担当者の記憶に頼る作業で起こりやすいでしょう。
たとえば、ネットワーク機器の設定変更で1行を誤るだけで、全社の通信が止まる場合があります。
IPアドレスの重複による通信の不安定も、典型的な例の一つです。
変更作業の前に手順と切り戻しの方法を決めておけば、影響は最小限に抑えられます。
2. 容量不足と高負荷
2つ目は、ディスクやメモリの容量不足と、処理の集中による高負荷です。
容量は日々少しずつ消費されるため、限界に達するまで異常に気づきにくい性質があります。
月末の締め処理や一斉のアクセスなど、負荷が一時的に跳ね上がる時期も注意が必要でしょう。
たとえばログやバックアップのファイルがディスクを埋め、データベースへの書き込みが止まる事態が起こりえます。
業務が拡大した後もサーバーの構成が導入時のままという状況も、容量不足を招く要因です。
使用率を監視し、上限に近づいた段階で増設や整理を行いましょう。
3. 機器の故障と老朽化
3つ目は、サーバーやネットワーク機器などハードウェアの故障です。
機器の部品には寿命があり、使用年数が長くなるほど故障の確率は高まります。
メーカーの保守期間が終わると、交換部品の入手や修理の依頼も難しくなるでしょう。
故障しやすい部品の代表は、ディスクや電源装置、冷却用のファンなど動く部品や熱を持つ部品です。
停電から機器を守るUPS(無停電電源装置)も、内部の電池が劣化すると役目を果たせなくなります。
機器ごとに導入時期と保守期限を台帳で管理し、計画的に更新を進めてください。
4. ソフトウェアの不具合
4つ目は、プログラムの不具合や更新プログラムに起因する障害になります。
ソフトウェアは多数の部品の組み合わせで動いており、一部の変更が別の機能に影響する場合があるからです。
例として、OSの更新プログラムを適用した直後に、業務システムが起動しなくなる事態が挙げられます。
サポートが終了したOSやソフトウェアを使い続けている場合も、修正が届かないため危険です。
更新は検証用の端末で先に試し、問題がないことを確かめてから全体へ展開しましょう。
5. 期限切れと更新漏れ
5つ目は、証明書やライセンス、契約の期限切れによる障害です。
期限切れは、ある日突然システムが使えなくなる形で表面化します。
期限は年に一度や数年に一度しか訪れず、担当者の交代で引き継ぎから漏れやすい項目でしょう。
代表例は、Webサイトやメールの暗号化に使うSSL/TLS証明書と、独自ドメインの更新です。
ソフトウェアのライセンスやクラウドサービスの支払いが止まり、アカウントが停止する例もあります。
期限のある項目を一覧にまとめ、期限の1〜2か月前に通知が届く仕組みを作っておきましょう。
6. サイバー攻撃
6つ目は、ランサムウェアや不正アクセスなどのサイバー攻撃です。
情報処理推進機構(IPA)の「情報セキュリティ10大脅威」組織編では、ランサム攻撃による被害が1位でした(出典:IPA「情報セキュリティ10大脅威 2026」2026年1月)。
システムの脆弱性を悪用した攻撃や、DDoS攻撃(大量の通信を送りつけてサービスを止める攻撃)も10位以内に入っています。
ランサムウェア(データを暗号化して身代金を要求する不正プログラム)に感染すると、業務の停止に直結するでしょう。
攻撃による障害は、復旧と並行して侵入経路の調査や関係機関への報告が求められる点で通常の障害と異なります。
更新プログラムの適用とバックアップの確保は、攻撃への備えとしても機能するものです。
7. クラウドサービスの停止
7つ目は、社外のクラウドサービスや通信事業者の側で起きる障害になります。
メールやファイル共有、会計などをクラウドで利用する企業では、事業者の障害が社内業務の停止につながるためです。
自社側で復旧作業を進められない点が、社内の障害との大きな違いでしょう。
大手のクラウド基盤で障害が起きると、基盤を利用する多数のサービスが同時に止まる場合もあります。
事業者の稼働状況を知らせるページ(ステータスページ)を、確認先として控えておくと安心です。
代替の連絡手段や手作業での運用方法を決めておくことが、事業者側の障害への主な備えになります。
8. 災害と停電
8つ目は、地震や水害、落雷や停電といった自然災害や設備の事故です。
災害はサーバーや回線を物理的に損傷させ、復旧までの期間が長くなりやすい傾向があります。
オフィスと同じ建物にサーバーとバックアップを置いている場合、両方を同時に失うおそれもあるでしょう。
落雷による瞬間的な停電でも、UPSがなければサーバーが強制的に停止し、データが壊れる場合があります。
ビルの法定点検に伴う計画停電も、停止の手順を決めていなければ障害の原因となるものです。
重要なデータは離れた場所に複製し、停電時の停止と再起動の手順を定めておきましょう。
事業への影響
障害の影響は、システムが止まっている間の不便だけにとどまりません。
復旧後も続く影響まで見込んで、備えの優先度を判断しましょう。
業務の停止と機会損失
直接的な影響は、システムに依存する業務が止まることです。
受注や出荷、請求の処理が止まれば、売上の機会を失います。
製造業では生産計画の遅れ、小売業では店舗での販売停止といった形で影響が表れるでしょう。
停止が長引くほど、取引先の業務にも影響が広がっていきます。
信用の低下
障害は、取引先や顧客からの信用にも影響を与えます。
説明が遅れたり内容が二転三転したりすると、障害の内容より対応の姿勢が問われやすいためです。
取引先から、再発防止策の提出や対策状況の説明を求められる場合もあるでしょう。
障害を完全に防ぐことは難しくても、誠実で速やかな情報開示は信用の低下を抑えられます。
復旧にかかる費用と工数
障害の復旧には、目に見える費用と見えにくい費用の両方がかかります。
ベンダーへの緊急対応の依頼や機器の交換は、目に見える費用の代表例です。
見えにくいのは、担当者の残業や休日の出勤、本来の業務の中断といった人的な負担でしょう。
障害対応が続くと担当者が疲弊し、離職のきっかけになるおそれもあります。
情報漏えいなどの二次被害
サイバー攻撃による障害では、システムの停止に加えて情報漏えいが起きる場合もあるでしょう。
一定の条件にあたる個人データの漏えいでは、個人情報保護委員会への報告と本人への通知が義務づけられています。
障害の原因が攻撃と判明した時点で、漏えいの有無の調査を並行して進めてください。
報告の期限や手順は、関連記事で詳しく解説しています。
関連記事:個人情報漏洩の対応マニュアル!発覚時の初動から報告義務まで解説
国内外の障害事例
実際に起きた障害から、原因と影響の広がり方を確認しましょう。
いずれも当事者が公表した情報をもとに要点をまとめました。
サイバー攻撃による物流の停止
食品大手のニチレイグループでは、サーバーへの不正アクセスによってシステム障害が発生しました。
冷蔵倉庫の入出庫業務と、冷凍食品の出荷業務に影響が及んでいます。
同社は直ちにシステムを遮断し、発生の11日後には全拠点で通常の稼働に戻しました。
続く調査では、53,866件の個人情報の漏えいも確認されたと公表されています(出典:株式会社ニチレイ「当社グループでのシステム障害発生について(第7報)」2026年9月)。
物流のように多数の取引先と結びつく業務では、1社の障害が取引先の出荷にも波及するでしょう。
業務を続けるための代替手段を用意しておく重要性がわかる事例です。
保守作業中の容量不足による工場停止
トヨタ自動車では、生産指示システムの不具合により、国内の車両工場の稼働が止まりました。
原因は、定期保守の作業中に作業用ディスクの容量が不足したことによるエラーです。
同じシステム上の予備のサーバーも同一の状態に陥り、切り替えによる復旧ができなかったと説明されています(出典:トヨタ自動車「先月の生産指示システムの不具合について」2023年9月)。
予備の機器を用意していても、同じ条件で動く構成では同時に止まる点は、冗長化を考えるうえで見落とせない教訓でしょう。
システム更改時の不具合による送金障害
銀行間の送金を担う全国銀行データ通信システムで、中継コンピュータの更改時に起きた障害の事例です。
10の金融機関で、他行あての振込などの処理ができなくなりました。
報告書では、更改に伴うプログラムの不具合で作業領域が不足し、データが破損したと説明されています(出典:全銀ネット「全国銀行データ通信システムの障害について」2023年12月)。
本番に近い条件での試験が不足していた点も、原因の一つに挙げられました。
大規模な変更作業ほど、本番と同じ条件での検証と切り戻しの準備が欠かせないとわかります。
セキュリティ製品の更新による端末停止
CrowdStrike社のセキュリティ製品の更新に不具合があり、世界中のWindows端末が起動できなくなりました。
Microsoftは、影響を受けた端末を約850万台、全Windows端末の1%未満と推計しています(出典:Microsoft「Helping our customers through the CrowdStrike outage」2024年7月)。
重要なサービスを担う多くの企業で業務が止まり、Microsoftは手動で復旧するための手順を公開しました。
自動で更新される仕組みでも、障害の引き金になりうるとわかる事例です。
クラウド基盤の障害による広域停止
Amazon Web Services(AWS)の米国東部のリージョンで、データベースサービスの障害が発生しました。
リージョンとは、データセンターが置かれた地域の単位です。
AWSは、名前解決(DNS)を自動で管理する仕組みの不具合が原因と説明しています(出典:AWS「Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region」2025年10月)。
AWS上で動く多数のサービスやアプリケーションに影響が広がり、利用企業の業務にも支障が出ました。
自社のシステムに問題がなくても、利用先の障害で業務は止まりうるという前提で備える必要があります。
事例に共通する教訓
5つの事例からは、規模や業種を問わず当てはまる教訓が見えてきます。
- 変更作業は障害の引き金になりやすい
更改や保守の作業は、手順と検証、切り戻しの準備をそろえてから行いましょう。 - 予備の機器も同時に止まる場合がある
冗長化の構成が、同じ原因で同時に停止しない設計かを確かめておく必要があります。 - 自社で直せない障害もある
クラウドや委託先の障害に備え、代替手段と連絡の経路を決めておいてください。 - 復旧の速さは平時の準備で決まる
遮断の判断やバックアップからの復元が、早期の再開を支えます。
次章からは、教訓を踏まえた障害時の判断と対応の手順に進みましょう。
障害レベルの決め方
障害が起きた際の判断を速くするために、あらかじめ障害レベルを定義しておきましょう。
レベルに応じて、連絡先や対応の体制を迷わず決められるようになります。
レベルを決める目的
障害レベルとは、業務への影響の大きさに応じて障害を段階分けする基準のことです。
レベルを決める目的は、判断の迷いによる初動の遅れをなくすことにあります。
障害の最中は、経営層へ報告すべきか、夜間でもベンダーを呼ぶべきかといった判断が次々に求められるでしょう。
判断の基準を事前に決めておけば、担当者が一人で抱え込む状況も避けられます。
レベル定義の例
一般的な企業を想定した、4段階の定義例を紹介します。
| レベル | 状態の目安 | 例 | 連絡先と初報の目安 |
|---|---|---|---|
| レベル1 重大 | 全社の業務が止まっている、または情報漏えいの疑いがある | 基幹システムの全面停止、ランサムウェアへの感染 | 経営層、全部署の責任者、ベンダーへ30分以内 |
| レベル2 高 | 複数の部署の業務が止まっている | メールやファイルサーバーの停止 | 情シスの責任者、影響部署の責任者、ベンダーへ1時間以内 |
| レベル3 中 | 一部の機能や利用者に影響があるが、代替手段がある | 特定の拠点での通信の不安定 | 情シスの責任者、影響部署へ当日中 |
| レベル4 低 | 業務への影響がほとんどない | 1台の端末の不具合 | 情シス内の定例の報告で共有 |
初報の時間は一例です。
自社の業務時間や体制に合わせて調整し、関係者が見られる場所に掲示しておきましょう。
判断に迷う場面の扱い
発生直後は情報が少なく、レベルを判断しきれない場面も多いでしょう。
迷った場合は高いほうのレベルで扱い、状況が見えてから下げる運用をおすすめします。
低く見積もって後から上げると、連絡の遅れが影響の拡大につながるためです。
レベルを下げた際も、関係者へ理由とあわせて伝えておくと混乱を防げます。
障害発生時の対応手順
障害が発生した際の対応は、6つのステップで進めます。
順番を決めておくと、慌ただしい状況でも抜け漏れを防げるでしょう。
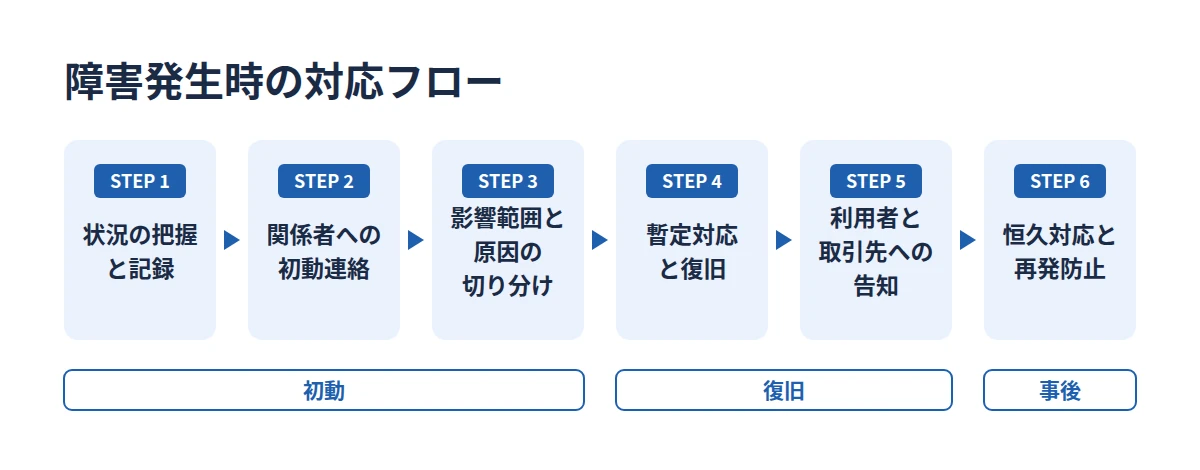
ステップ1 状況の把握と記録
最初に、何が起きているのかを事実として把握します。
推測と事実を分けて整理することが、以降の判断の土台になるものです。
申告を受けたら、次の項目を確かめましょう。
- 発生した時刻
- 使えないシステムや機能
- 影響を受けている利用者や拠点の範囲
- エラーメッセージや画面の状態
- 直前の変更作業の有無
確認と並行して、対応の経過を時刻とあわせて記録し始めてください。
記録は、関係者への報告や報告書の作成にも活用できます。
ステップ2 関係者への初動連絡
状況の概要がつかめたら、障害レベルに応じて関係者へ初報を送ります。
初報では、詳しさよりも速さを優先しましょう。
初報には、発生時刻と影響範囲、対応状況と次の報告予定時刻の4点を入れます。
原因が不明な段階でも、「原因は調査中」と明記すれば十分な初報になるでしょう。
次の報告時刻を必ず添えると、問い合わせの集中を抑えられます。
利用者向けには、社内チャットや一斉メールなど障害の影響を受けない手段を使ってください。
保守契約のあるベンダーへの連絡も、同じタイミングで済ませておくと復旧が早まります。
ステップ3 影響範囲と原因の切り分け
次に、障害が起きている箇所を絞り込みます。
切り分けは、利用者に近い側から順に確かめていくと効率的です。
- 端末
他の端末や別の利用者でも同じ症状が出るかを確かめます。 - ネットワーク
同じ拠点から社外のWebサイトや他のサービスに接続できるかを確認しましょう。 - サーバー
稼働状況と、CPUやメモリ、ディスクの使用率を調べてください。 - 外部サービス
クラウドサービスが原因と疑われる場合は、事業者のステータスページで障害情報を確かめます。
切り分けと同時に、直前の変更作業やアラートの履歴も確認してください。
変更作業の直後に起きた障害なら、作業を元に戻すことで復旧できる可能性が高いためです。
事業者の発表が出る前は、利用者の報告を集める障害情報サイトが参考になる場合もあります。
最終的な判断は、事業者の公式情報に基づいて行いましょう。
ステップ4 暫定対応と復旧
原因の見当がついたら、業務を再開させるための暫定対応を行います。
暫定対応とは、根本的な解決の前に影響を止める応急的な処置のことです。
代表的な手段は、変更の取り消しや予備の機器への切り替え、処理の再実行などでしょう。
システムの復旧を待つ間は、手作業や代替のツールで業務を続ける方法も検討してください。
復旧後は、利用者の側で正常に使えるかを確かめてから復旧を宣言します。
サイバー攻撃が疑われる場合は、端末をネットワークから切り離し、電源は切らずに専門家の指示を待ちましょう。
ログや画面の状態が、侵入経路を調べるための重要な手がかりになるからです。
関連記事:ランサムウェア感染からの復旧方法は?正しい手順や費用相場、NG行動を解説
ステップ5 利用者と取引先への告知
社外に影響が及ぶ障害では、取引先や顧客への告知が必要になります。
告知の内容に迷わないよう、項目をあらかじめ決めておきましょう。
| 項目 | 記入例 |
|---|---|
| 発生日時 | ○月○日9時15分ごろから |
| 影響の内容 | 受注サイトで注文を確定できない状態 |
| 現在の状況 | 原因を調査し、復旧作業を進めています |
| 次回の報告予定 | 本日12時までに続報を掲載します |
| 問い合わせ先 | 担当部署の名称と連絡先 |
告知では、判明している事実のみを記載し、推測による原因の説明は控えてください。
お詫びの言葉に加えて、利用者が取るべき行動を示すと問い合わせの削減にもつながるでしょう。
ステップ6 恒久対応と再発防止
業務が再開したら、根本的な原因を取り除く恒久対応に移ります。
暫定対応のまま放置すると、同じ障害が再び起きるおそれがあるためです。
恒久対応には、設定の見直しや機器の交換、プログラムの修正や手順書の改訂が含まれます。
原因の分析と対策は、次章で紹介する障害報告書にまとめて関係者と共有しましょう。
初動で避けたい行動
障害の最中は焦りから、かえって状況を悪化させる行動を取りがちです。
代表的な行動を確認しておきましょう。
- 原因を確かめないまま再起動を繰り返す
- 担当者の判断だけで設定を変更する
- 対応の経過を記録せずに作業を進める
- 推測の段階の原因を社外に伝える
- 攻撃が疑われる端末の電源を切り、ログを消す
作業の前に、内容を別の担当者やベンダーと確かめる習慣をつけてください。
一つの判断の誤りが、次の障害を招く場面もあるためです。
障害対応の手順づくりは「情シス君」へ
連絡体制から一次対応まで整備をご支援します
「障害のたびに対応が場当たり的になってしまう」
「連絡先や判断の基準が、担当者の記憶にしか残っていない」
障害時の対応は、手順と役割が文書になっているほど速く正確になるものです。
「IT顧問 情シス君」は、障害レベルの定義や連絡体制の整備から、発生時の一次対応までお手伝いします。
サービス資料では、障害対応の体制を整える流れと、情シス君が担える作業の範囲を確認できます。
自社で整える部分と外部に任せる部分を判断する材料としてご活用ください。
障害報告書の書き方
障害が収束したら、経緯と原因、再発防止策を障害報告書にまとめます。
報告書は、経営層への説明と社内の知見の蓄積という2つの役割を持つ文書です。
報告書の記載項目
報告書には、次の項目を盛り込みましょう。
| 項目 | 書く内容 | 記入例 |
|---|---|---|
| 概要 | 何が起き、どの業務に影響したか | 基幹システムが停止し、受注を入力できなかった |
| 発生と復旧の日時 | 発生、検知、暫定復旧、完全復旧の各時刻 | 9時15分に発生、9時20分に検知、11時40分に暫定復旧 |
| 影響範囲 | 影響を受けた部署、利用者数、取引先 | 営業部と物流部の約80名、取引先への出荷遅延3件 |
| 経緯 | 時系列での対応内容 | 9時30分にベンダーへ連絡、10時に予備機へ切り替え |
| 直接原因 | 障害を引き起こした直接のきっかけ | ディスクの空き容量がなくなった |
| 根本原因 | 直接原因を招いた背景 | 容量の監視を設定しておらず、増加に気づけなかった |
| 暫定対応と恒久対応 | 実施した処置と今後の処置 | 不要なファイルを削除し、ディスクを増設する |
| 再発防止策 | 担当者と期限を決めた対策 | 容量の監視を設定し、月次で使用率を確認する |
記入例のように数値と時刻を具体的に書くと、経営層も状況を把握しやすくなります。
社外向けの報告を求められた場合は、社内向けの内容から機密情報を除いて作成するとよいでしょう。
原因の掘り下げ方
報告書の要は、直接原因の奥にある根本原因まで掘り下げる作業になります。
直接原因への対処だけでは、形を変えて同じ障害が繰り返されるためです。
掘り下げの際は、「なぜ起きたか」を複数回問い直す方法が役立つでしょう。
たとえば「ディスクが満杯になった」理由を問うと、「監視を設定していなかった」という答えに行き着きます。
さらに理由を問うと、「設定の担当者が決まっていなかった」という仕組みの問題が見えてくるはずです。
原因は個人の責任ではなく、仕組みの問題として記載してください。
担当者を責める報告書は、次の障害で事実が報告されにくい組織を生みます。
障害管理表での記録
報告書とは別に、すべての障害を1つの表で記録する障害管理表を用意しましょう。
件数や原因の分類を集計すると、特定の機器や作業に障害が集中している傾向が見えてきます。
管理表の項目は、概要と原因の分類、対応状況に絞ると続けやすいでしょう。
月に一度は未完了の対策を確認し、再発防止策の実施が止まっていないかを点検してください。
関連記事:インシデント管理とは?ITシステムにおける具体的な手順、効果的に運用する方法を解説
平時に進める予防策
障害の発生を減らし、発生時の影響を小さくするための予防策を8つ紹介します。
すべてを一度に進める必要はなく、自社で起きやすい障害に効く対策から着手しましょう。
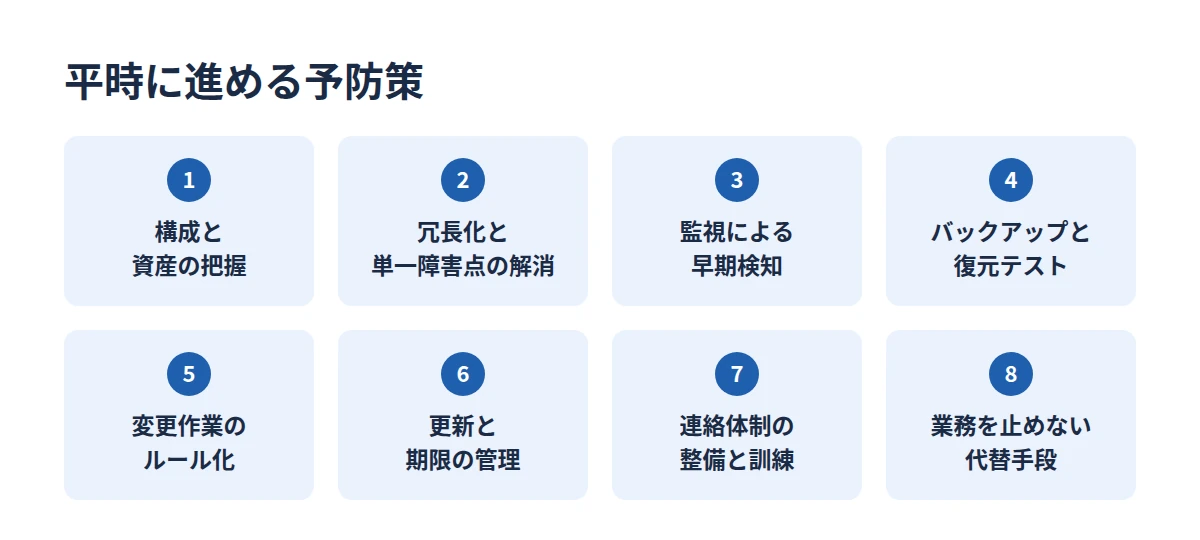
1. 構成と資産の把握
1つ目は、社内のシステム構成とIT資産の正確な把握になります。
構成がわからなければ、障害の切り分けも影響範囲の見積もりもできないからです。
担当者の記憶にしかない構成は、異動や退職と同時に失われてしまいます。
最低限そろえたいのは、ネットワーク構成図と機器の台帳、利用しているクラウドサービスの一覧です。
台帳には、機器の設置場所や導入時期、保守の連絡先まで記載しておくと障害時に役立つでしょう。
構成図と台帳は、変更のたびに更新する運用とあわせて整備してください。
関連記事:IT資産管理とは?必要性やよくある問題、効率的な管理方法を解説
2. 冗長化と単一障害点の解消
2つ目は、1か所の故障で全体が止まる箇所をなくす冗長化です。
冗長化とは、機器や回線を二重にして片方が止まっても動き続ける構成を指します。
止まると全体が停止する箇所は単一障害点と呼ばれ、障害の影響を大きくする要因になるためです。
インターネット回線やルーター、ファイルサーバーが1台ずつしかない構成は、典型的な単一障害点でしょう。
ただし前述の事例のように、予備の機器が同じ条件で動いていると同時に停止する場合があります。
回線は別の事業者を選び、データは別の場所に置くなど、障害の原因を分ける設計を心がけてください。
費用に限りがある場合は、止まったときの影響が大きい箇所から順に二重化しましょう。
3. 監視による早期検知
3つ目は、異常を利用者より先に見つけるための監視になります。
利用者からの申告で障害に気づく状態では、初動がどうしても遅れるからです。
監視を設定しておけば、容量不足のように予兆のある障害は発生前に防げるでしょう。
| 監視の種類 | 確認する内容 |
|---|---|
| 死活監視 | 機器やサーバーが応答しているか |
| リソース監視 | CPUやメモリ、ディスクの使用率 |
| ログ監視 | エラーや不審なアクセスの記録 |
| サービス監視 | Webサイトや業務システムを利用者の側から正常に使えるか |
| 期限の監視 | 証明書やライセンスの有効期限 |
通知が多すぎると重要なアラートが埋もれるため、しきい値と通知先を定期的に見直してください。
夜間や休日に誰が通知を受け取るかも、あわせて決めておきましょう。
関連記事:ネットワーク保守とは?運用との違い・仕事内容から外注のメリットまで徹底解説
4. バックアップと復元テスト
4つ目は、バックアップの取得と、実際に戻せるかを確かめる復元テストになります。
バックアップは、実際に復元できて初めて意味を持つためです。
ランサムウェアはバックアップも狙うため、社内のネットワークにつながったままの保管では不十分な場合もあります。
基本の考え方は、データを3つ保持して2種類の媒体に保存し、1つは別の場所に置く3-2-1ルールです。
攻撃への備えとしては、書き換えや削除ができない形式での保管も有効でしょう。
復元の手順は年に1回以上試し、復旧にかかる時間も記録しておきましょう。
5. 変更作業のルール化
5つ目として、設定変更や更新の作業を決まった手順で行うルールを整えましょう。
事例でも見たとおり、変更作業は障害の引き金になりやすいためです。
担当者の経験に頼った作業は、人が変わると品質も変わってしまうでしょう。
ルールに含めたい項目は、次の4点です。
- 作業手順書と確認項目の作成
- 実施前の別の担当者による内容の確認
- 失敗した場合の切り戻し手順の準備
- 業務への影響が少ない時間帯での実施
小さな変更でも記録を残すと、障害時に直前の変更を追いやすくなります。
6. 更新と期限の管理
6つ目は、更新プログラムの適用とサポート期限、各種の有効期限の管理になります。
更新の遅れは攻撃の入り口となり、期限の見落としはある日突然の停止を招くためです。
サポートが終了したOSやソフトウェアは、脆弱性(セキュリティ上の弱点)が見つかっても修正されないまま残ります。
更新プログラムは検証用の端末で動作を確かめてから、全体へ計画的に適用しましょう。
OSのサポート期限や証明書、ライセンスの期限は、1つの台帳にまとめて管理するのがおすすめです。
台帳の担当者を1人に決め、四半期ごとに期限の近い項目を確認してください。
関連記事:脆弱性対策とは?発生原因や被害事例、対策手法を解説
7. 連絡体制の整備と訓練
7つ目として、障害時の連絡体制を文書にまとめ、訓練で使える状態に保ちましょう。
連絡先や手順がまとまっていても、使ったことがなければ本番で機能しにくいからです。
特に夜間や休日は担当者が不在の場合も多く、連絡の順番が決まっていないと初動が大きく遅れます。
整備しておきたい資料は、次のとおりです。
- 障害レベルごとの連絡先と連絡の順番
- ベンダーの窓口と保守契約の番号
- 社内と社外への告知の文面の雛形
- 主要なシステムの復旧手順書
年に1〜2回は、障害を想定した机上訓練を行ってください。
連絡網をたどるだけの訓練でも、登録された番号の誤りや担当者の異動に気づけるはずです。
8. 業務を止めない代替手段
8つ目は、システムが止まっても業務を続けるための代替手段の準備になります。
どれだけ予防策を講じても、障害を完全になくすことはできないためです。
止まった場合の動き方を決めておけば、復旧までの影響を小さく抑えられるでしょう。
準備の起点は、業務ごとに目標復旧時間と目標復旧時点を決めることです。
目標復旧時間は再開までの許容時間、目標復旧時点はどの時点のデータまで戻せればよいかを示します。
受注を紙の伝票で受け付ける、普段と別の連絡手段を用意するといった方法を具体的に決めておきましょう。
事業継続計画(災害や障害の際に事業を続けるための計画)と連動させると、全社で動きをそろえられます。
少人数の情シスでの備え
障害への備えを、1〜2名の情シスだけで整えるには限界もあるでしょう。
体制が小さいからこそ、社内で持つ役割と外部に任せる役割を決めておくことが重要です。
担当者が一人の体制のリスク
情シスの担当者が一人の場合、担当者の不在時に障害が起きると対応できる人がいなくなります。
休暇や出張の間も、障害への不安から完全には業務を離れられない状況になりがちでしょう。
手順や設定の情報が1人に集中していると、退職や休職で一気に失われるおそれもあります。
手順書の整備と、代わりに動ける人の確保を並行して進めましょう。
関連記事:ひとり情シスはなぜつらい?現場が抱える課題と解決策をわかりやすく解説
ベンダーとの役割分担
障害時に頼りになるのが、機器やシステムの保守を担うベンダーです。
ただし保守契約の範囲や対応時間を把握していないと、緊急時に動いてもらえない場合があります。
契約ごとに、対応の時間帯と到着までの目安、SLA(サービスの品質を保証する取り決め)を確認しておきましょう。
複数のベンダーが関わる場合は、切り分けの責任をどこが持つかを決めておくと、責任の押し付け合いを防げます。
関連記事:ベンダーコントロールとは?発注側が押さえたい5つの実践手法を解説
外部の専門家との分担
社内の人員だけで足りない部分は、外部の専門家と分担する方法も有効です。
判断は社内に残し、作業と専門知識を外部から補う形にすると、社内の負担を抑えながら体制を整えられます。
| 役割 | 社内で持つ部分 | 外部と分担できる部分 |
|---|---|---|
| 障害レベルの判断 | 最終的な判断と経営層への報告 | 判断材料の整理と助言 |
| 監視と一次対応 | 通知を受けた後の業務上の判断 | 監視の設定、アラートの確認、初期の切り分け |
| 復旧作業 | 業務を再開する時期の判断 | 機器の設定、ベンダーとの調整 |
| 報告書 | 内容の承認と社内への共有 | 原因の分析と報告書の作成支援 |
| 予防策 | 優先順位と予算の決定 | 構成図と台帳の整備、手順書の作成 |
外部の専門家は、社内に知見のない領域の相談相手としても頼れる存在でしょう。
一人で抱え込まない体制づくりが、障害への備えの土台になります。
少人数の情シスを「情シス君」が補います
障害対応と予防策の整備を必要な範囲だけご支援
「担当者が一人で、障害時に相談できる相手がいない」
「予防策に着手したいが、日々の問い合わせ対応で時間が取れない」
体制の不足は、外部の専門家と役割を分けることで補えるものです。
「IT顧問 情シス君」は250社以上の支援実績をもとに、監視や一次対応から構成図の整備まで必要な範囲をご支援します。
サービス資料では、支援できる業務の範囲と月額の考え方を紹介しています。
社内に残す役割と外部に任せる役割を決める材料としてご活用ください。
よくある質問
情報システムの障害について、よく寄せられる質問に回答します。
障害が起きたら最初に何をすべきですか?
何が起きているかを事実として把握し、記録を始めてください。
発生時刻と影響範囲、直前の変更作業の有無を確かめたら、障害レベルに応じて関係者へ初報を送ります。
原因の特定より先に、状況の共有を優先しましょう。
ベンダー側が原因の場合の責任は?
責任の範囲は、保守契約や利用規約の内容で決まるのが一般的です。
多くのクラウドサービスでは、品質の基準を下回った場合の補償を利用料の一部返還に限っています。
契約時に補償の範囲を確認し、判断に迷う場合は法務の担当者や弁護士に相談してください。
クラウドの障害はどこで確認できますか?
各事業者が公開しているステータスページが、確実な確認先です。
Microsoft 365の場合は、管理センターの「サービス正常性」で確かめられます。
主要なサービスの確認先を一覧にまとめ、障害時の手順書に載せておきましょう。
サイバー攻撃による障害かを見分けるには?
身代金を要求する画面や、ファイルの拡張子が一斉に変わる現象は、攻撃を強く疑う兆候です。
身に覚えのないアカウントの作成や、深夜の大量の通信も判断材料になります。
疑わしい場合は攻撃を前提に端末を隔離し、専門家へ相談してください。
障害報告書はいつまでに出しますか?
初報は当日中、詳細な報告書は原因と対策が固まった段階で提出するのが一般的です。
社内の規程で「レベル1は10営業日以内」のように期限を決めておくと、運用しやすくなります。
原因の調査が長引く場合は、途中経過を中間報告として共有しましょう。
夜間や休日の障害にはどう備えますか?
監視の通知を受け取る担当者と、連絡がつかない場合の代わりの担当者を順番に決めておきます。
ベンダーとの契約で、夜間や休日の対応が範囲に含まれるかも確認が必要です。
社内で対応しきれない場合は、夜間の監視や一次対応を外部に委託する方法もあるでしょう。
再発防止は何から始めればよいですか?
過去の障害を障害管理表に書き出し、原因の分類ごとに件数を数えるところから始めてください。
件数の多い分類に効く予防策を優先すると、少ない労力で効果を得やすくなります。
記録がない場合は、今後の障害から記録を始めるだけでも十分な一歩です。
まとめ|備えは平時に決まる
本記事では、情報システムの障害が起きる原因と発生時の対応、平時の予防策を解説しました。
要点を振り返ります。
- 障害の定義
停止だけでなく、遅延や一部機能の不全も障害として扱う - 障害の原因
設定ミスや容量不足などの内部要因と、攻撃やクラウドの停止などの外部要因がある - 障害レベル
影響の大きさで段階を決め、連絡先と初報の目安を結びつける - 対応の6ステップ
把握・連絡・切り分け・暫定対応・告知・恒久対応の順で進める - 予防策
構成の把握や監視、バックアップ、変更作業のルール化を平時に整える
障害への対応は、発生してから考え始めても間に合いません。
連絡先と判断の基準、代替手段を平時に決めておくことが、障害時の迷いをなくす確かな備えです。
まずは自社の障害レベルを定義し、連絡先の一覧を作るところから始めてみてください。
1枚の一覧表があるだけで、障害時の初動は大きく変わるはずです。
情報システムの障害対策は「情シス君」へ
構成の把握から監視・運用までご支援します
障害への備えは、現状の構成を把握するところから始まります。
「IT顧問 情シス君」は、株式会社デジタルハックが提供する総合IT支援サービスです。
構成図や台帳の整備から監視や一次対応まで、必要な範囲だけをご一緒します。
サービス資料では、障害対応の体制づくりから日常の運用まで、支援の範囲と進め方を具体的に紹介しています。
社内で担う範囲と外部に任せる範囲を決める材料としてご活用ください。